LLM простыми словами: что это и как использовать ее в SEO
Треть российских интернет-пользователей начинает поиск с готового ответа нейросети в выдаче, а еще 17% сразу открывают чат с ИИ — такие данные получили ВШЭ и OMI в июле 2026 года. В США, по подсчетам SparkToro, в начале 2026 года 68% запросов в Google заканчивались без единого клика, в том числе из-за AI-обзоров. Их составляют LLM — большие языковые модели. Разбираем, что такое LLM, как они устроены и как использовать их в SEO.
Что такое LLM (большая языковая модель)
LLM-модель (от англ. Large Language Model — «большая языковая модель») — это нейросеть, которую обучили на огромном массиве текстов предсказывать следующее слово. Слово за словом модель подбирает самое вероятное продолжение и складывает связный ответ — так чат-боты отвечают на вопросы, пишут, переводят.
Модель и сервис — не одно и то же. ChatGPT, Claude, Алиса AI и Perplexity — приложения, а LLM — их «двигатель». Сервис добавляет к движку удобный интерфейс и доступ к поиску.
От других нейросетей LLM отличают:
- Масштаб. «Большой» модель называют из-за числа параметров — внутренних настроек, в которых хранится все, что она усвоила при обучении. У GPT-3 их было 175 миллиардов, у открытой DeepSeek-V3 — 671 миллиард. Чем больше параметров, тем лучше модель справляется со сложными задачами — и тем дороже ее запуск. Самые крупные модели уже перешагнули отметку в триллион — например Kimi K2 от Moonshot AI, вышедшая в 2025 году.
- Естественный язык. Вместо «кабачки рецепт без духовки» можно спросить: «Что приготовить из кабачков, если духовка сломалась, а гости придут через час?» — модель учтет все условия.
- Контекст. LLM помнит диалог: на просьбу «А теперь короче» она поймет, что сокращать.
Зачем это знать неспециалисту
Нейросетями регулярно пользуются ваши клиенты: просят подобрать сервис или сравнить товары. Одна из важных задач бизнеса — попасть в AI-обзоры. Для этого нужно заниматься LLM-оптимизацией сайта или GEO (Generative Engine Optimization). Оптимизация под LLM — дополнение классического SEO, а не его замена.
Кроме того, LLM — полезный рабочий инструмент. Модели пишут мета-теги и черновики, разбирают отзывы. Понимая их устройство, проще оценить, где модель сэкономит время.
Чем LLM отличается от нейронных сетей и ИИ
Чтобы понять, чем LLM отличается от нейросетей и ИИ, представьте матрешку. Искусственный интеллект (ИИ, или AI) — самое широкое понятие. Это любые системы, которые решают задачи, требующие «человеческого» мышления. Нейросети — способ создать такую систему: программа не следует прописанным правилам, а учится на примерах. LLM — нейросети, которые понимают и генерируют текст. Поэтому любая LLM — это и нейросеть, и AI, но не наоборот.
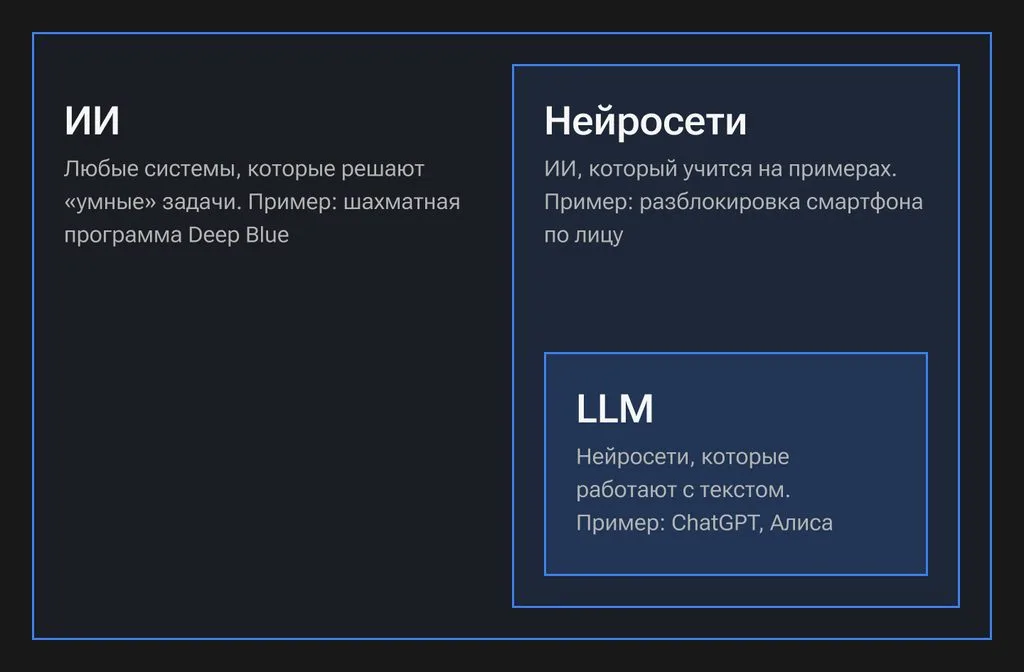
Как не путать ИИ, нейросети и LLM
Разницу проще всего увидеть на примерах:
| Понятие | Пример |
| ИИ | Шахматная программа Deep Blue, обыгравшая Гарри Каспарова в 1997 году. Вместо самообучения или нейросетевых весов Deep Blue опиралась на заранее запрограммированные алгоритмы поиска по дереву ходов и сложную стационарную функцию оценки позиции, которую настраивали гроссмейстеры |
| Нейросеть, но не LLM | Разблокировка смартфона по лицу, генерация картинок в Шедевруме и Midjourney: эти нейросети распознают лица или рисуют, но текст не пишут |
| LLM | GPT (на ней работает ChatGPT), Claude, GigaChat, DeepSeek, модели Алисы AI |
Как работает LLM
LLM не понимает смысл так, как человек: у нее есть только статистика того, какие слова обычно стоят рядом. На «Мама мыла...» модель ответит «раму» не потому, что представляет маму и окно, а потому, что часто видела это сочетание. Правдоподобное продолжение не обязательно верное, поэтому модель может галлюцинировать — уверенно писать неправду.
Ответ собирается по кусочкам: модель выбирает следующий фрагмент, добавляет его к тексту, повторяет цикл.
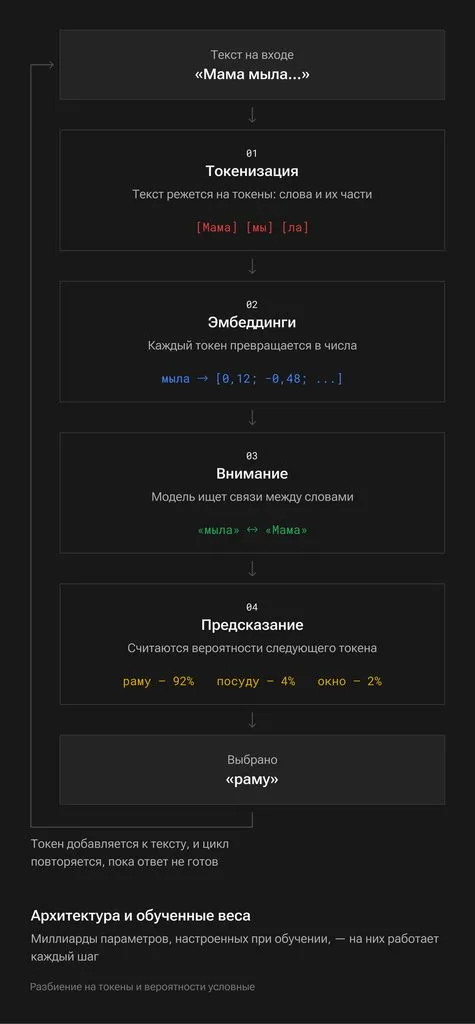
Токенизация
Токен — это фрагмент текста, с которым работает модель: слово, его часть или знак препинания. Частые слова обычно занимают один токен, а редкие делятся на несколько: «кот» может быть одним токеном, а «переоптимизированный» — тремя-четырьмя. Так модель обходится словарем из десятков или сотен тысяч фрагментов — она собирает из них любое слово, даже незнакомое.
Что из этого следует:
- Объем и цена считаются в токенах. По оценке OpenAI, в английском тексте токен в среднем равен 0,75 слова. Русские слова обычно «весят» больше. При работе через API платят за миллион токенов: у Anthropic миллион токенов ответа флагманской Claude Fable 5.1 стоит $50, младшей Claude Haiku 4.5 — $5. Поэтому сложный анализ разумно отдавать сильной модели, а мета-теги для тысячи карточек — модели попроще.
- Модель не видит букв. Слово для нее — набор токенов. Поэтому LLM долго ошибались в вопросе «Сколько букв r в слове strawberry?».
Эмбеддинги
Эмбеддинг (от англ. embedding — «вложение») — это набор чисел, в который модель превращает каждый токен: нейросеть умеет только считать. Его удобно представить как карту, где похожие по смыслу слова «живут по соседству»: кофе рядом с чаем, а экскаватор — на другом конце. Только координат у этой карты не две, а сотни и тысячи.
На этом принципе построен поиск по смыслу. Яндекс сравнивает смысл запроса и страницы нейросетями с 2016 года (алгоритмы «Палех» и «Королев»), Google — с 2018-го (Neural matching). LLM-сервисы тоже часто подбирают фрагменты по близости эмбеддингов. Поэтому страница о беговых кроссовках может попасть в ответ на запрос «в чем бегать по асфальту», даже если такой фразы в ней нет. И наоборот: от многократного повтора ключей страница не станет ближе к пользовательскому запросу. Модель сопоставляет не количество вхождений, а общий смысл.
Механизм внимания
Механизм внимания — это способ, которым модель связывает слова между собой: перед выбором следующего токена она решает, какие из предыдущих сейчас важны. Допустим, вы спрашиваете модель: «Где рядом сделать дубликат ключа от квартиры?» Она свяжет «ключ» с «квартирой» и «дубликатом» и поймет, что нужна мастерская по изготовлению ключей. А в задании «Ключ „купить кофемашину“ вынесите в заголовок» модель обратит внимание на кавычки и слово «заголовок». Она поймет, что ключ — это поисковый запрос, который нужно поставить в H1.
У внимания есть пределы. Исследование Стэнфорда Lost in the Middle (2023) показало: в длинных текстах модели хуже учитывают середину, чем начало и конец. Поэтому в длинном промпте ставьте главное в начало или повторяйте в конце.
Предсказание следующего токена
На каждом шаге модель рассчитывает вероятности для всех токенов словаря и выбирает один, а вернуться и исправить его уже не может. Если ответ начался со слова «Да», дальше она, скорее всего, будет подбирать аргументы «за», даже если верный ответ — «нет». Поэтому полезно просить: «Разбери варианты по шагам и только потом сделай вывод».
Архитектура и обученные веса
Архитектура — это устройство модели, а веса — ее содержимое: те самые миллиарды параметров, настроенные при обучении. Большинство LLM построены на архитектуре «трансформер», которую исследователи Google описали в статье Attention Is All You Need (2017). Буква T в GPT — это как раз Transformer. Поэтому модели различаются прежде всего весами: тем, на каких данных и как их обучали.
Веса формируются в три этапа:
- Предобучение. Модель учится предсказывать следующий токен на огромном массиве текстов: книгах, коде, страницах сайтов — вашего тоже, если он открыт для краулеров. Например, DeepSeek-V3 обучали примерно на 14,8 триллиона токенов. После этого этапа модель знает язык и массу фактов, но на вопрос «Как сварить борщ?» может ответить аналогичным вопросом. Например, начнет спрашивать «Как сварить щи? Как приготовить солянку?» — будто продолжает ветку на кулинарном форуме.
- Дообучение. На чужих диалогах модель учится вести себя как ассистент: отвечать по существу и выполнять инструкции.
- Обучение на оценках людей (RLHF, Reinforcement Learning from Human Feedback). Люди выбирают лучшие ответы, и модель учится выдавать похожие. Побочный эффект — склонность поддакивать: людям приятны согласие и уверенный тон.
После обучения веса не меняются: на вашем диалоге модель не учится. Но разработчик может обучать на диалогах будущие версии, если это разрешено настройками, — помните об этом, прежде чем загружать в чат данные клиентов.
Что реально влияет на ответы LLM
На ответ LLM влияют пять факторов:
| Фактор | Что определяет | Кто может повлиять |
| Данные обучения | Что модель «знает» без поиска: факты, представления о брендах и товарах | Владелец сайта — косвенно, через то, что о компании пишут в интернете |
| Размер модели | Как она справляется со сложными задачами | Пользователь — выбирая модель |
| Настройки сервиса | Системный промпт — скрытая инструкция разработчика о тоне и запретных темах — и параметры генерации, например температура | Разработчик сервиса или пользователь API |
| Запрос | Задача, контекст, формат и объем ответа | Пользователь — полностью |
| Доступ к поиску | Свежие данные и источники, на которые модель сошлется | Владелец сайта — на этом строится LLM-оптимизация |
Почему одна и та же модель отвечает по-разному
У разных сервисов на одной LLM разные системные промпты: бот поддержки магазина откажется обсуждать рецепт борща, а универсальный ассистент его распишет. Но и в одном чате ответы различаются из-за трех вещей:
- Температура. Модель иногда берет не самый вероятный токен. При низкой температуре ответы предсказуемые, при высокой — разнообразнее, но и ошибок больше. Если на фактический вопрос модель каждый раз отвечает по-новому, она, скорее всего, не уверена.
- Контекст. Контекст в LLM — это все, что модель видит в момент ответа: вопрос, предыдущие сообщения, системный промпт, файлы. Объем, который она учитывает за раз, называется контекстным окном: у современных моделей это от сотен тысяч до миллиона токенов. В очень длинном диалоге ранние сообщения могут выпасть, поэтому новую задачу лучше начинать в новом чате.
- Свежесть знаний. Обучающие данные заканчиваются на дате среза знаний. О более поздних событиях модель без поиска не знает и может уверенно выдать устаревшую информацию.
Какие бывают LLM-модели
LLM различают по доступу, размеру и назначению:
- По доступу. Закрытыми пользуются через сервис или API разработчика: это GPT, Claude, Gemini. Открытые можно скачать и запустить у себя: Qwen, DeepSeek. У Яндекса и Сбера есть модели обоих типов — например в сентябре 2026 года Сбер открыл GigaChat 3.5 Reasoning.
- По размеру и назначению. Большие модели работают на серверах, компактные помещаются даже в смартфон. Универсальные решают любые текстовые задачи, специализированные дообучены, например под код.
Единого рейтинга лучших LLM нет: лидеры меняются каждые несколько месяцев, а «лучшая» модель зависит от задачи. Свежие сравнения есть на LMArena, где пользователи вслепую голосуют за ответы моделей.
Открытые и закрытые модели: что выбрать
Закрытая модель — готовый сервис: вы платите за подписку или токены, остальное берет на себя разработчик. Такие модели обычно самые сообразительные, но при работе с ними данные уходят на чужие серверы. К тому же ChatGPT и Claude официально в России не работают, поэтому российскому бизнесу проще опираться на модели Яндекса или Сбера.
Открытая модель — это опубликованные веса. Ее можно запустить на своем сервере, чтобы данные клиентов никуда не уходили, и дообучить на своих текстах, но придется платить за железо и специалистов. Для текстов и SEO-задач проще начать с закрытой модели. Открытую стоит рассматривать, если данные конфиденциальные или задач так много, что токены дороже своего сервера.
Для каких задач LLM применяются сегодня
LLM пишут и редактируют тексты, отвечают в чат-ботах, переводят, анализируют таблицы и пишут код. Все чаще они действуют сами — ищут информацию, заполняют документы: такие системы называют AI-агентами. Лучше всего модели перерабатывают готовый материал. Чем больше им приходится досочинять, тем строже нужно проверять результат.
Примеры для маркетинга и SEO
Вот где LLM экономит время команды и что за ней проверять:
| Задача | Что дать модели | Что проверить |
| Контент-план | Аудиторию, товары, сезонность, список опубликованных статей | Спрос в Wordstat: модель не знает частотности и может предложить темы, которые никто не ищет |
| Черновик статьи | ТЗ, факты с источниками, пример текста в нужном тоне | Каждую цифру, а еще клише и повторы, по которым узнают нейротекст |
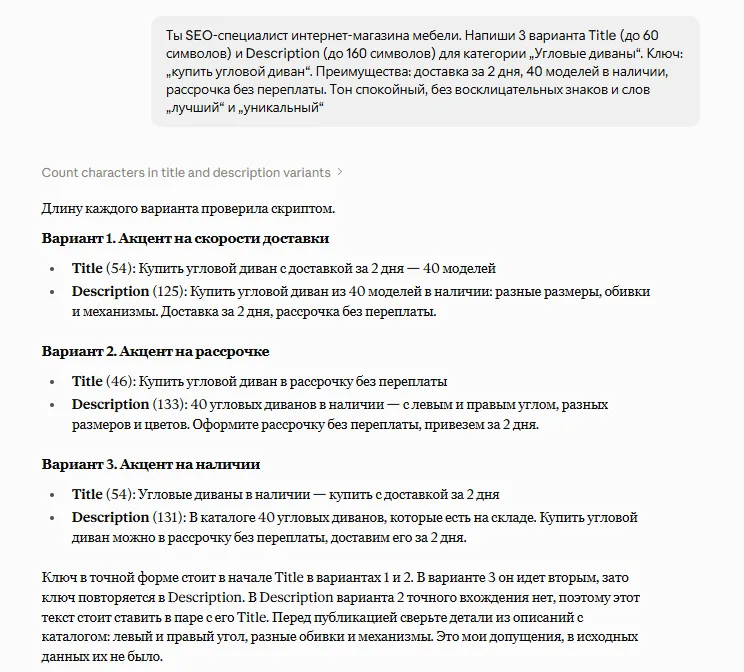
| Мета-теги | Текст или URL страницы, ключ, лимит длины, преимущества | Длину и уникальность |
| Кластеризация запросов | Список запросов и принцип группировки | Сверку с выдачей: поисковик группирует не так, как модель. Надежнее кластеризовать по топу в Rush Analytics или Пиксель Тулс, а модель подключать для спорных случаев |
| Анализ отзывов | Выгрузку отзывов или обращений в поддержку | Пропорции: модель может раздуть редкую тему. Зато она находит формулировки клиентов для FAQ |
Чем конкретнее запрос, тем меньше правок. Вот как может выглядеть задание на мета-теги:
Что нужно для запуска LLM
Все зависит от того, насколько глубоко вы встраиваете LLM в работу:
- Подписка на сервис — для текстов и разовых задач.
- API — если модель работает внутри процессов: пишет описания для каталога или отвечает клиентам на сайте. Нужны ключ доступа, разработчик и, если модель отвечает по вашим документам, база знаний.
- Своя модель — нужны сервер с видеокартами, специалисты по настройке и бюджет на поддержку.
Готовое API или локальный запуск
Готовое API похоже на аренду: вы платите только за токены. Подключиться можно за день, а простые связки «таблица → модель → таблица» собираются мышкой в no-code-сервисах, например n8n. Но расходы растут вместе с объемом.
Локальные LLM работают на вашем оборудовании: открытую модель можно скачать бесплатно, а платить нужно за железо, электричество и поддержку. Попробовать можно на ноутбуке, например с помощью LM Studio: компактной модели на 7–8 миллиардов параметров хватит 16 ГБ оперативной памяти. Для моделей на десятки миллиардов нужен сервер.
Начинать разумно с API: это дешевле, чем покупать сервер под задачу с недоказанной пользой.
Техническая доступность сайта для LLM (robots.txt, llms.txt, Schema.org)
Чтобы LLM процитировала страницу, сервис должен ее найти. AI-ассистенты с доступом к поиску работают по схеме Retrieval-Augmented Generation, или сокращенно RAG («генерация с опорой на найденное»): находят подходящие фрагменты страниц и передают их модели вместе с вопросом. Так работают ChatGPT с поиском, Perplexity, Алиса AI в Яндексе и AI Overviews в Google. Сайт может попасть в нейровыдачу, если до него доберется краулер — робот, просматривающий все страницы в интернете. Поэтому оптимизация сайта под LLM начинается с технической доступности: AI-роботы должны попадать на страницы и видеть их текст.
Robots.txt. Через этот файл в корне сайта вы говорите роботам, куда им можно смотреть, а куда нельзя. Каждый робот ищет в нем правила для себя по имени (user-agent) и, как правило, их соблюдает. У AI-компаний несколько роботов: одни собирают тексты для обучения моделей, другие ищут источники для ответов. Вот о чем стоит знать:
- OpenAI. GPTBot собирает тексты для обучения, OAI-SearchBot — для поиска в ChatGPT. А вот ChatGPT-User открывает страницы по прямой просьбе пользователя, поэтому, как предупреждает OpenAI, может не соблюдать robots.txt.
- Google. Токен Google-Extended управляет использованием контента для обучения и работы Gemini и на поиск не влияет. В AI Overviews страницы попадают из обычного индекса.
- Яндекс. Токен YandexAdditional запрещает использовать сайт в быстрых ответах YandexGPT и, по словам Яндекса, не влияет на ранжирование.
Так можно запретить обучение на своих текстах и остаться в поиске ChatGPT:
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
Частая ошибка — закрыть доступ для всех AI-ботов: тогда сайт пропадет из ответов нейросетей.
Индексация и позиции. Google пишет, что для AI Overviews странице достаточно быть в индексе с разрешенным сниппетом. Важный текст должен быть в HTML: по данным Vercel, на конец 2024 года крупные AI-краулеры, кроме роботов Google и Apple, JavaScript не выполняли. В Яндексе важны позиции: по данным «Ашманов и партнеры», доля сайтов не из топ-10 в ответах Алисы с августа 2025 по январь 2026 года сократилась вчетверо, до 10%.
llms.txt. Это предложенный в 2024 году файл со списком главных страниц сайта в формате Markdown. Стандартом он не стал: Google в гайде по генеративному поиску пишет, что такие файлы не нужны, другие крупные сервисы поддержку не подтверждали. Вреда от него нет, но и эффекта тоже.
Schema.org. Микроразметка помогает поисковикам понять, что на странице. Она не влияет напрямую на попадание в ответы нейросетей. Ahrefs сравнили 1885 страниц с новой разметкой с контрольной группой и роста цитирований в AI Overviews, AI Mode и ChatGPT не увидели. Для расширенных сниппетов разметка по-прежнему полезна.
Что проверить в первую очередь
- robots.txt не закрывает Googlebot, роботов Яндекса и OAI-SearchBot;
- запрет на обучение, если он нужен, настроен точечно — через GPTBot и Google-Extended;
- важные страницы в индексе, сниппеты не запрещены;
- основной текст есть в HTML-коде.
Как оптимизировать контент под LLM
LLM-сервис цитирует не страницу целиком, а фрагмент. Поэтому каждый раздел должен быть законченным ответом, понятным без остального текста:
- Структура. Под каждым заголовком сразу ответ по сути, детали — после.
- Вопросы-ответы. Подзаголовки звучат так, как спрашивают люди: «Сколько стоит...», «Чем отличается...». Такой ответ модели проще найти и процитировать.
- Естественный язык. Поисковые системы и модели сопоставляют тексты по смыслу, поэтому синонимы не мешают, а переспам ключами не помогает.
При этом Google оговаривается: дробить текст на мелкие куски и писать особым языком для ИИ не нужно. Структура, удобная людям, удобна и моделям.
Также важна фактура. Исследователи Принстона и их коллеги в работе GEO: Generative Engine Optimization выяснили, что статистика, цитаты экспертов и ссылки на источники повышают видимость текста в генеративных ответах до 40%, а добавление ключевых слов почти ничего не дает.
Кроме того, стоит работать над повышением видимости продукта. Ahrefs изучили 75 тысяч брендов: с появлением в AI Overviews сильнее всего связаны упоминания бренда в интернете (корреляция 0,664), а обратные ссылки — втрое слабее (0,218). Поэтому публикации в отраслевых медиа работают не только на поиск, но и на нейровыдачу.
Практический чек-лист для текста
Ваш текст может попасть в AI-обзоры, если:
- каждый H2 начинается с ответа на вопрос из заголовка;
- определения построены по модели «X — это...»;
- в абзаце 2–5 предложений и одна мысль;
- у всех цифр, на которые вы опираетесь, есть источники;
- в статье есть то, чего нет у конкурентов: опыт, кейсы, данные;
- сравнения оформлены в виде таблиц или списков.
Преимущества и ограничения LLM
Главные плюсы LLM — скорость, масштаб и гибкость. Черновик, на который у копирайтера уходит день, модель способна написать за пару минут — а еще за 10–15 она отредактирует текст с учетом всех требований. Та же модель с помощью API за ночь обработает тысячи карточек товаров, переведет на несколько языков и поможет разместить на сайте (который создаст специально для этой цели).
Минусы — выдуманные факты, устаревшие знания и зависимость от формулировки запроса.
Когда LLM лучше не использовать
- Ошибка стоит дорого. Медицинские, юридические и финансовые темы Google относит к YMYL (Your Money or Your Life — «ваши деньги или ваша жизнь») и оценивает особенно строго. Любую информацию по этой теме должен перепроверить эксперт.
- Нужны точные расчеты. Модель предсказывает тексты, но может допустить несколько ошибок в расчетах. Если не хотите проверять вычисления самостоятельно, воспользуйтесь специализированными нейросетями — например Gauth.
- Нужен уникальный опыт. Кейс или собственное исследование модель не напишет, а именно такой контент выделяет сайт и в выдаче, и в ответах нейросетей.
- Данные конфиденциальные. Договоры и персональные данные безопаснее обрабатывать в локальной модели или в сервисе, где договор запрещает обучение на ваших данных.
Как оценить перспективы использования LLM в продукте
LLM стоит внедрять, если выполняются три условия:
- задача повторяется — описания товаров, мета-теги, ответы на типовые вопросы;
- есть исходные данные — характеристики, база знаний, история обращений;
- ошибку легко заметить и недорого исправить — неудачный мета-тег поправит редактор, а неверный ответ клиенту о возврате обойдется дороже.
Бюджет считайте целиком: токены обычно дешевле всего, а основные расходы — время разработчика и редактора.
Мини-пилот вместо большого внедрения
Проверьте пользу на одной задаче — например на мета-тегах для 100 карточек.
Шаг 1. Зафиксируйте точку отсчета. Сколько времени и правок уходит на карточку сейчас.
Шаг 2. Прогоните карточки через модель. Дайте ей данные о товарах и подробный запрос.
Шаг 3. Сравните результат. Время, число правок, доля текстов, ушедших в публикацию без изменений.
Шаг 4. Примите решение. Если редактор переписывает больше половины, меняйте запрос или задачу. Если результат устраивает, масштабируйте на весь каталог.
Как измерить результат: метрики, инструменты
Результат измеряют с двух сторон. Первая — эффект в работе: время на задачу, число правок, стоимость единицы контента. Следите за ними и после пилота: с обновлениями модели качество меняется. Вторая — видимость в нейровыдаче, и точных инструментов здесь пока нет.
Какие метрики смотреть в SEO
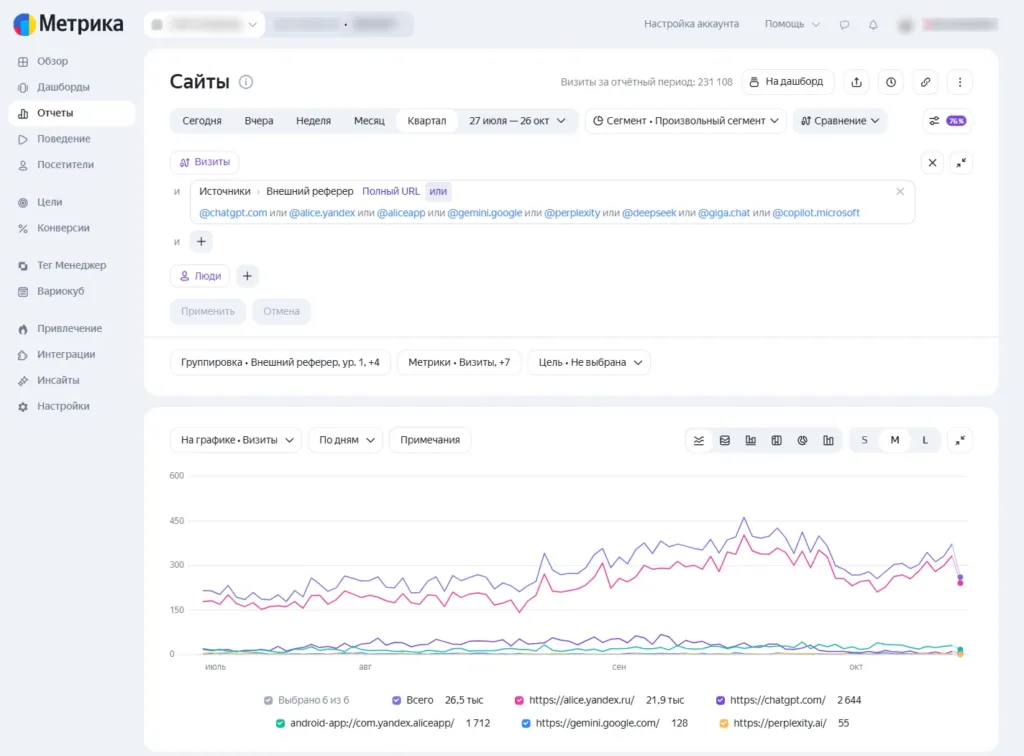
- Переходы из AI-сервисов. В Яндекс Метрике и GA4 видны визиты с chatgpt.com, perplexity.ai и других сайтов, а ChatGPT еще и добавляет к ссылкам метку utm_source. Заведите отдельный сегмент и смотрите на конверсии.
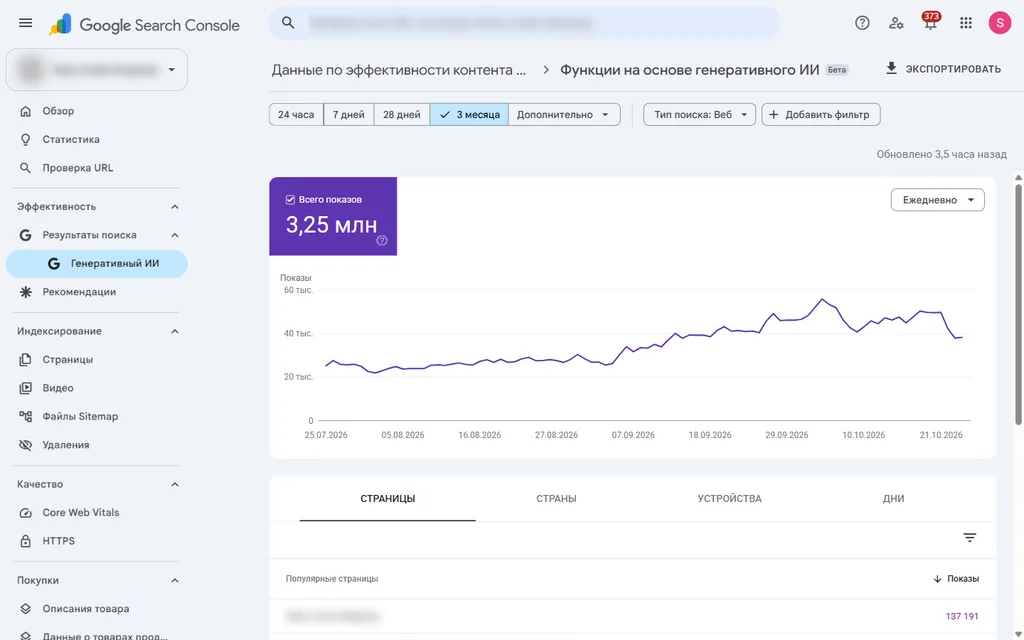
- Показы и CTR. В Google Search Console данные AI Overviews и AI Mode входят в общий отчет об эффективности и отдельно не выделяются. Если показы по информационным запросам растут, а CTR падает, возможно, пользователю отвечает AI-обзор.
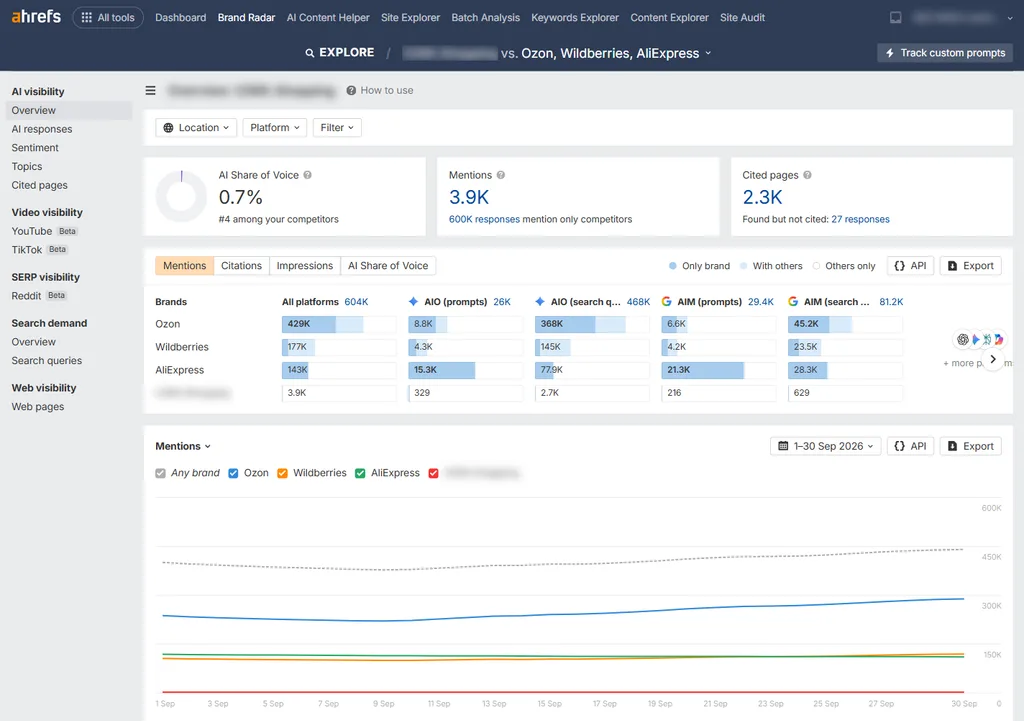
- Упоминания бренда. Раз в месяц задавайте ChatGPT, Perplexity и Алисе AI 20–30 типовых вопросов аудитории и фиксируйте, есть ли бренд и ссылка на сайт. Помогают Ahrefs Brand Radar и Semrush, но и они смотрят выборку, поэтому следите за динамикой.
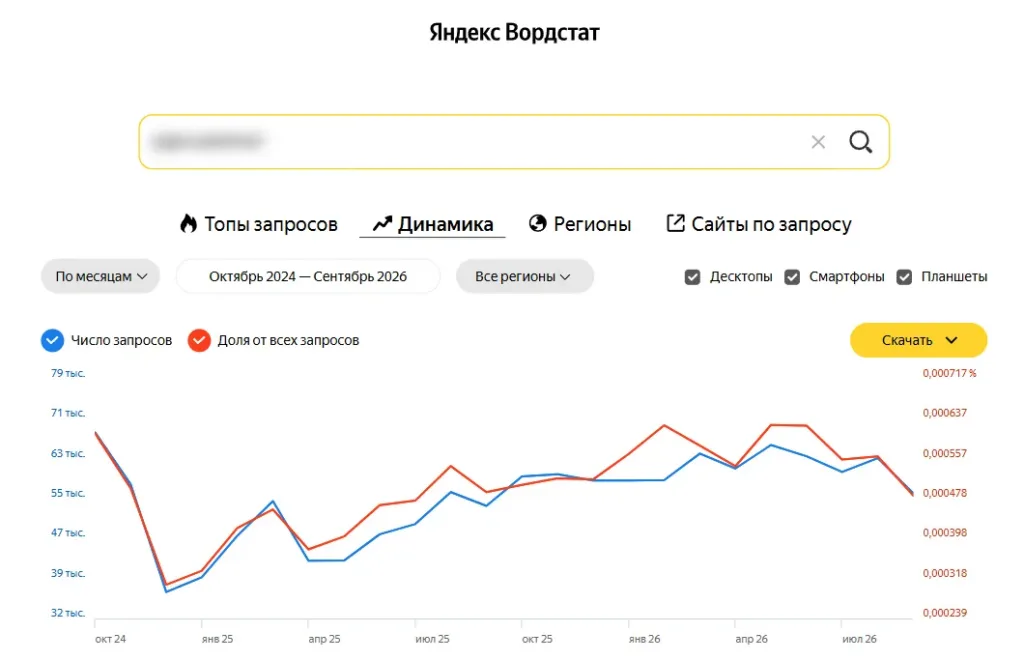
- Брендовый спрос. Рост брендовых запросов в Wordstat — косвенный признак того, что нейросети советуют вашу компанию.
Типичные ошибки
- Публиковать ответ модели без проверки. Даже сильная LLM может выдумать цифру или цитату, а одна замеченная ошибка подрывает доверие ко всему сайту.
- Генерировать страницы потоком. Сотни однотипных страниц ради трафика Google считает злоупотреблением масштабированным контентом. С мая 2026 года правила против спама прямо распространяются на генеративные ответы.
- Писать для нейросетей, а не для людей. Переспам и блоки «вопрос — ответ» после каждого абзаца отпугивают читателей и не помогают моделям.
- Накручивать упоминания. Google предупреждает, что искусственные упоминания не так полезны, как кажется: AI-ответы опираются на те же системы, что отсекают спам.
- Давать задачу в одну строку. На запрос «Напиши статью про диваны» модель выдаст усредненный текст, похожий на тысячи других.
- Ждать гарантий. Ответы нейросетей меняются, а принципы отбора источников не раскрываются. Если подрядчик гарантирует попадание в ChatGPT за месяц, это повод насторожиться.
LLM уже стали частью поиска. Чтобы оказаться среди источников их ответов, сайту нужно быть доступным для AI-роботов и отвечать на вопросы ясно, с фактами и собственным опытом. Если хотите попадать в ответы нейросетей или внедрить LLM в работу с контентом, обращайтесь за помощью к команде WSS.
Часто задаваемые вопросы (FAQ)
LLM — что это?
LLM — сокращение от Large Language Model, что значит «большая языковая модель». LLM-модель — разновидность искусственного интеллекта: нейросеть, обученная на огромном массиве текстов предсказывать следующее слово.
Чем LLM отличается от других нейросетей?
LLM работает с языком: понимает вопросы в свободной форме и пишет связный текст. Другие нейросети распознают лица, генерируют картинки или подбирают музыку.
Как работает LLM?
LLM разбивает текст на токены и превращает их в числа. С помощью механизма внимания модель определяет, какие слова важны, рассчитывает вероятности и выбирает следующий токен — и так, пока ответ не будет готов.
Где применяется LLM?
LLM применяют в чат-ботах, переводе, анализе данных, программировании и работе с текстами. В маркетинге и SEO модели помогают с контент-планами, черновиками, мета-тегами, анализом отзывов и группировкой запросов.